大家好,我是TIMEWELL的濱本。Claude Code、Codex、Grok Build。這一年來,在終端機裡自主寫程式、跑測試、連文件都整理好的程式代理(coding agent),已成為開發現場的標準配備。我們公司也每天在用好幾種代理。只是,變方便的同時,代理也變重了。交付一件工作,它會在背後呼叫模型數十次,讀取整個程式碼庫,反覆嘗試。結果是,越來越多公司在月底時,token費用被排上經營會議的議程。
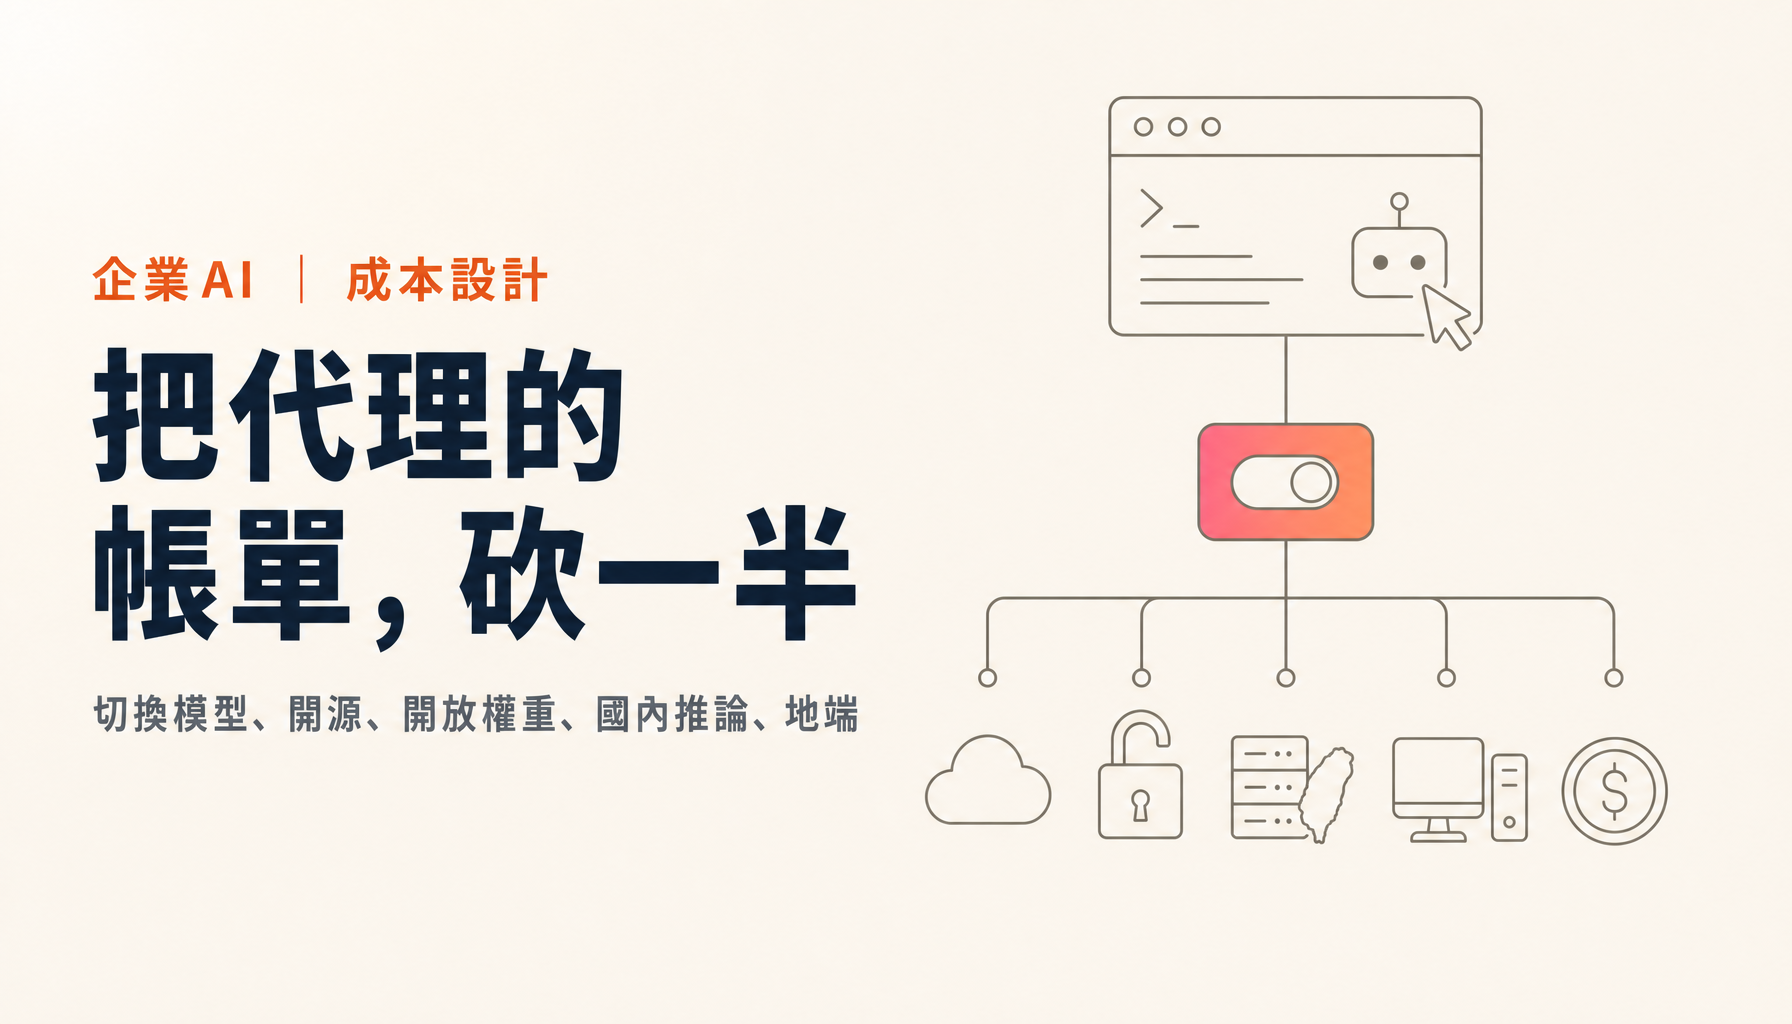
這篇文章的主題就是怎麼把這個成本降下來。先講結論,做法有五種:切換代理所連接的模型;使用開源的代理;使用開放權重的模型;使用國內的無伺服器推論服務;以及在公司內部放置GPU。每一種都有官方文件能確認的事實,也有實際做了才會發現的陷阱。老實說,沒有哪一種能單獨解決全部問題。所以最後會為初學者說明,把這些組合起來、「讓資料留在國內、同時降低成本」的AI閘道器這個思路。
為什麼代理這麼貴。先掌握token的算法
首先從機制說明為什麼程式代理比聊天貴。AI模型的使用費以「token」為單位計算。日文大約一個字一個token,英文大約四個字母一個token。送給模型的文字(輸入)與模型回傳的文字(輸出)都有單價,多數模型的輸出單價大約是輸入的五倍。
在聊天裡問一個問題,輸入輸出各幾千token就夠了。代理不一樣。你說一句「修好這個bug」,代理會讀相關檔案、跑測試、讀結果、寫修正案、再試一次。每一次,它都會把到目前為止的對話與檔案內容整批當作輸入重送。動輒數十萬token,大型工作到數百萬token並不罕見。
單價依官方價目表確認。Anthropic的Claude Opus 5每100萬token輸入5美元、輸出25美元。Claude Sonnet 5輸入2美元、輸出10美元。Claude Haiku 4.5輸入1美元、輸出5美元。最高階的Claude Fable 5.1則是輸入10美元、輸出50美元1。xAI的Grok 4.6輸入2美元、輸出6美元,程式專用的grok-build-0.1輸入1美元、輸出2美元2。假設有10位開發者每天用Opus 5消耗500萬token輸入與50萬token輸出,一天的費用是輸入25美元加輸出12.5美元再乘以10,等於375美元;一個月20個工作天就是7,500美元,以1美元150日圓計算約112萬日圓。這就是「token費用成為經營議題」的實際內容。
同一份價目表也寫著降價的機制。使用提示快取(prompt caching),重複送出部分的輸入單價降到基本價的十分之一;可以非同步處理的工作改走Batch API,輸入輸出都是半價1。降低成本這件事,在換模型之前,要先確認現在的模型的折扣有沒有用滿。
做法一。切換代理所連接的模型
第一種做法,是繼續使用代理本身,但改變它在背後呼叫的模型。這裡必須把「技術上做得到」與「官方支援」分開說明。
OpenAI的Codex CLI官方支援這種切換。在設定檔寫入model_providers.<id>項目,base_url填連線目標的API網址,env_key填存放API金鑰的環境變數名稱,就能連接OpenAI以外的相容API。另外還有--oss旗標,把oss_provider設為ollama或lmstudio,就能直接切換到在自己電腦上運作的本機模型3。也就是說,Codex CLI從一開始就設想在OpenAI以外的模型上運作。
xAI的Grok Build的官方文件也有加入自訂模型的方法。在設定檔~/.grok/config.toml建立[model.my-model]項目,model填模型ID、base_url填連線目標、env_key填API金鑰的環境變數,再在[models]的default指定,該模型就成為預設4。Grok Build本身是2026年5月才公開的新工具,特色是最多能並行執行8個子代理,以及這種連線目標的自由度。
Anthropic的Claude Code情況稍有不同。官方文件有一節「Other LLM gateways」,說明用ANTHROPIC_BASE_URL這個環境變數,經由組織自行營運的閘道器連線的方法。列出的閘道器優點包括:憑證不必放在終端機、追蹤每位開發者的用量、統一管理預算與速率限制、稽核日誌,以及不動開發者的電腦就能切換供應商。但同一頁也明白寫著:「Anthropic不推薦、維護或稽核第三方閘道器產品,也不支援經由任何閘道器把Claude Code路由到非Claude模型」5。在閘道器的另一端接上說著Anthropic相容API的其他模型,技術上成立,但那是自負責任的領域。
我的整理是這樣:切換連線目標,在Codex CLI與Grok Build是官方功能,在Claude Code則是利用官方閘道器功能的非官方用法。無論哪一種,如果切換過去的模型不支援代理內部使用的工具呼叫格式,運作就會不穩定。「接了便宜的模型之後就不幫我編輯檔案了」這種諮詢實際上很多,原因幾乎都不是模型能力,而是工具呼叫的相容性。
做法二。使用開源的代理
第二種,是把代理本身換成開源的。有兩個代表。
OpenCode是可以當作終端機介面、桌面應用程式、IDE擴充功能使用的開源程式代理,官方文件寫著「設定API金鑰就能使用任何LLM供應商」6。設計上不綁定特定模型公司,切換模型是前提而不是附加功能。
Hermes Agent是Nous Research公開的MIT授權代理,在GitHub上累積了超過24萬顆星。README寫著「想用什麼模型都可以。Nous Portal、OpenRouter、OpenAI、自己的端點,還有很多」,用hermes model指令就能不改程式碼地切換7。
過去,開源代理總有「誰來負責」的疑慮。代理會改寫檔案、執行指令,失控時損害很大。這一點,Hermes Agent的官方資安文件走得相當深。它用Docker、Modal、Daytona等沙箱把代理的指令與主機隔離,在Docker以--cap-drop ALL降低權限。對~/.ssh、~/.aws、~/.kube、/etc/sudoers、~/.netrc,以及代理本身的憑證與.env的寫入被無條件禁止,也能把寫入目標限制在指定的目錄範圍。危險指令在預設的「smart」模式下由輔助LLM評估風險,即使在省略確認的YOLO模式,rm -rf /這類毀滅性操作仍維持硬性封鎖。處理URL的工具有SSRF防護,阻擋對內部網路與雲端中繼資料的存取。傳給MCP子程序的環境變數被限制到最少,錯誤訊息中的API金鑰會自動遮蔽8。責任所在仍然在使用者這一邊,但已經到了「守住了什麼」可以用文件確認的水準。
選擇開源代理的現實理由,我認為與其說是成本本身,不如說是把模型的選擇權握在自己手上。當代理的提供者同時也是模型的提供者,面對漲價或規格變更就沒有談判的餘地。把代理與模型分離,模型市價下降時就能立刻受惠。
做法三。使用開放權重的模型
第三種,是把模型本身換成開放權重的。開放權重模型是指模型內部(權重)公開、任何人都能下載到自己的環境運作的模型。中國的研究機構與企業公開的Kimi、GLM、MiniMax、Qwen、DeepSeek,NVIDIA的Nemotron,Google的gemma,OpenAI的gpt-oss等,到了2026年主要的提供者已經到齊。
開放權重的優點,是能把模型的提供者與模型運作的地點分開。中國企業做的模型在日本業者的伺服器上運作、資料不出日本的配置;或是在自家GPU上運作、通訊本身不出公司的配置。兩者都成立。反過來說,如果透過提供者自己的API使用開放權重模型,在資料去向這一點上,就與其他雲端模型沒有差別。不是「開放權重所以安全」,而是「開放權重所以能選擇在哪裡運作」,這樣理解才準確。
另一個優點,是不容易被供應者的決定牽著走。雲端模型會依提供者的判斷改變效能,舊模型也會停止提供。手上有權重,至少能避免「昨天還能用、今天不能用」的情況。這一點,我在默默降級模型是信任的問題那篇寫過。
成本不是只由模型的單價決定。開放權重模型的成本,由運作它的地點的費用決定。接下來的兩種做法,談的就是這個「運作地點」。
做法四。使用國內的無伺服器推論
第四種,是使用國內業者以API形式提供開放權重模型的所謂無伺服器推論服務。美國有Fireworks AI、Together AI這類業者開拓了這個領域,日本也出現了同類型的服務。
代表例子是SAKURA internet於2025年9月正式提供的「AI Engine」。官方網站標榜「全部在國內雲端完成,不向外部傳送資料」,提供OpenAI相容的Chat Completions API與Responses API,以及Anthropic相容的Messages API。模型有OpenAI的gpt-oss-120b、日本國產的llm-jp-3.1,預覽版則有Qwen3、Phi-4、Kimi-K2、gemma-4-31B-it等。費用方面,gpt-oss-120b輸入每1萬token 0.15日圓、輸出0.75日圓;免費方案的Chat Completions每月可用3,000次9。
把這些數字與前面的Claude Opus 5並列看。換算成每100萬token,gpt-oss-120b輸入15日圓、輸出75日圓;Opus 5以1美元150日圓計算,輸入750日圓、輸出3,750日圓。光看單價有50倍的差距。模型的能力當然不同,複雜的設計判斷或大規模重構,用高階模型結果反而更便宜的情況也有。但例行的程式碼生成、測試樣板、日誌摘要、commit訊息的生成這類工作,不需要每次都用最高階模型。光是依工作類型分流模型,帳單的形狀就會改變。
AI Engine擁有Anthropic相容的Messages API這件事,與做法一組合時就有意義。因為技術上可以把Claude Code的ANTHROPIC_BASE_URL指向閘道器,再由閘道器依工作類型把請求分流到國內的開放權重模型。再說一次,這是Anthropic不支援的用法5。即便如此,作為在國內完成資料處理、同時降低成本的一條路,值得列入選項。
做法五。在公司內放GPU。地端與本機LLM的現實
第五種,是自己持有GPU、在公司內運作模型。這一年來,這個選項變得現實了。NVIDIA的DGX Spark擁有128GB統一記憶體,官方網站表示可在桌上推論最多2,000億參數的模型,也支援最多700億參數的微調,並將它定位為「讓代理與大型模型在本機運作、減少對雲端token生成的依賴」的機器10。用搭載大容量記憶體的Mac Studio跑開放權重模型的開發者也變多了。更進一步,也有企業在公司內部放置搭載數張資料中心等級GPU的伺服器。
地端的優點很明確:token單價變成零,而且資料物理上不會離開公司。對處理圖面或客戶資料的部門來說,第二點通常是決定性的。
但實際做了會發現三個弱點。第一,網頁搜尋與外部工具的整合。雲端代理的搜尋、文件參照等整套流程由提供者最佳化過,本機則得自己組,這裡的品質差距就是體感的差距。第二,速度。同樣的模型,在手邊一台機器上,與在數千張GPU上並行處理的雲端,輸出速度不同;代理會呼叫模型數十次,一次的延遲會累積。第三,維運。模型更新、驅動程式與執行環境的管理、故障時的處理,都會變成某個人的工作。token費用是零,人事費與電費不是零。
我的看法是,地端不是「全部在這裡做」,而是「把不能外流的資料相關工作集中到這裡」。需要最新模型的工作交給雲端,機密性高的工作留在公司內。這種分流靠人力做一定會漏,所以需要機制。那就是下一節的話題。
串起五種做法的「讓資料留在國內的AI閘道器」
到此為止的五種做法,單獨看都不完整。切換模型能省錢,但依工作不同,最適合的模型也不同。開放權重很自由,但不決定運作地點就沒有意義。國內無伺服器便宜又在國內完成,但拿不出最高階的能力。地端安全,但慢又難維運。把這些整合成一套方針的,就是AI閘道器。
AI閘道器是放在代理或應用程式與模型之間的中繼伺服器。再列一次Anthropic官方文件提到的優點:集中管理憑證、追蹤每位使用者的用量、統一管理預算與速率限制、稽核日誌、不動開發者的電腦就能切換供應商,共五項5。對企業來說真正的價值,在於這裡可以放「規則」。例如,含有圖面的請求只送給國內模型的規則;commit訊息的生成交給最便宜的模型的規則;夜間批次處理走半價的Batch API、特定部門可以用最新模型但超過月預算就切換到國內模型的規則。這些規則不是由每位開發者各自設定,而是由公司在一個地方決定。
我們所說的「具備資料主權的AI」,正是這種狀態:哪些資料在哪裡運算、放在哪裡,由公司自己決定、自己說明。成本最佳化與資料管理看似是不同的課題,其實在閘道器這同一個地方解決。我們把企業用的ZEROCK放在AWS的日本區域運作,做成可透過Amazon Bedrock指定日本區域模型的配置。部分最新模型在全球區域推論,但不會用客戶資料再訓練。作為這個設計的延伸,針對想在公司內持續運作AI代理、讓自動化一直轉下去的企業,我們也在開發讓資料留在國內、同時降低成本的閘道器。從「試用」代理走到「每天運轉」的企業,越需要這個零件。
結語。降價之前,先決定分流
程式代理的成本,不是把模型換成便宜的一個就會降下來這麼簡單。現在的模型的折扣用滿了嗎?代理的連線目標能用官方方法切換嗎?要不要用開源代理把選擇權拿回自己手上?開放權重模型要在哪裡運作?國內無伺服器與公司內GPU,各分配給哪些工作?把這些不當成個人的巧思,而是當成公司的方針放在一個地方,就是閘道器。
把這篇確認過的事實整理一下:Codex CLI與Grok Build官方就有連線目標的切換,Claude Code官方說明可經由閘道器,但明記非Claude模型不在支援範圍。Hermes Agent這類開源代理,已經到了用文件標示沙箱與禁止寫入路徑的水準。像AI Engine這樣在國內同時提供OpenAI相容與Anthropic相容API的業者出現了,gpt-oss-120b的輸出每100萬token是75日圓。而DGX Spark這類機器,讓2,000億參數的模型在桌上運作。材料都齊了。
這一週如果只做一件事,請把自家的代理使用分成「處理不能外流資料的工作」「需要最新模型的工作」「便宜模型就夠的工作」三類,算出各自的比例。光是這樣,就能看出該從哪一種做法著手。想討論分流規則的設計,或在公司內持續運作代理的基礎架構,歡迎從個別諮詢聯絡我們。我們會先聽狀況,再一起思考架構。
參考資料
費用與規格均依2026年9月12日時點的官方文件。匯率換算以1美元150日圓概算。