こんにちは、株式会社TIMEWELLの濱本です。2026年11月5日、Thinking Machines Labが新しいモデル「Inkling 2 Small」を発表しました1。最初にお伝えしたいのは、日本の企業が気にする点のうち、重みの公開がまだ先だということです。公式は「外部の安全性テストとレッドチーミングのあと、来週、Apache 2.0で重みを公開する意向」と書いています。2026年11月6日の時点では、当面Tinkerというプラットフォーム上でクローズドの重みとして提供されているだけです1。
この記事では、公式の発表文とモデルカード、第三者の集計、Hugging Faceに載っている同社の既存モデルを一つずつ読み、次の四つに答えます。一つ目は、どこまで良くなったのか。二つ目は、どのくらい重いのか。三つ目は、なぜ日本で「中国以外のオープンウェイト」を求める声が出るのか。四つ目は、公開されたら最初に何を確かめるのか。読者として思い浮かべているのは、情報システム部門や調達、法務の方、そしてAI活用の方針を決める経営の方です。
要約 Inkling 2 Smallは、総パラメータ5,940億(594B)のうち1トークンあたり170億(17B)だけを使うMoEモデルで、NVFP4という4ビット浮動小数点でネイティブに事前学習されています。Artificial Analysisの指数v5.0.1では31で、一覧で確認できた中国以外のオープンウェイト(Mistral Large 4が26)を上回る位置です。ただし重みはまだ公開前で、公開される重みの精度とファイルサイズは公式に書かれていません。重さは、同社の既存モデルの実例から見て、4ビット系なら300GB台と推定されます。個人のPCでは動かせない規模です。公開後に更新する前提で読んでください。
先に押さえる言葉
専門用語が続くので、先に表にまとめます。以降の説明で迷ったら、ここに戻ってください。
| 言葉 | 意味 | たとえ |
|---|---|---|
| オープンウェイト | 学習済みのパラメータ(重み)を公開し、誰でも自分の環境で動かせるモデル。ソースコードや学習データまで公開する「オープンソース」とは別 | 料理のレシピ全文ではなく、完成した料理(の冷凍パック)を渡してもらうようなもの |
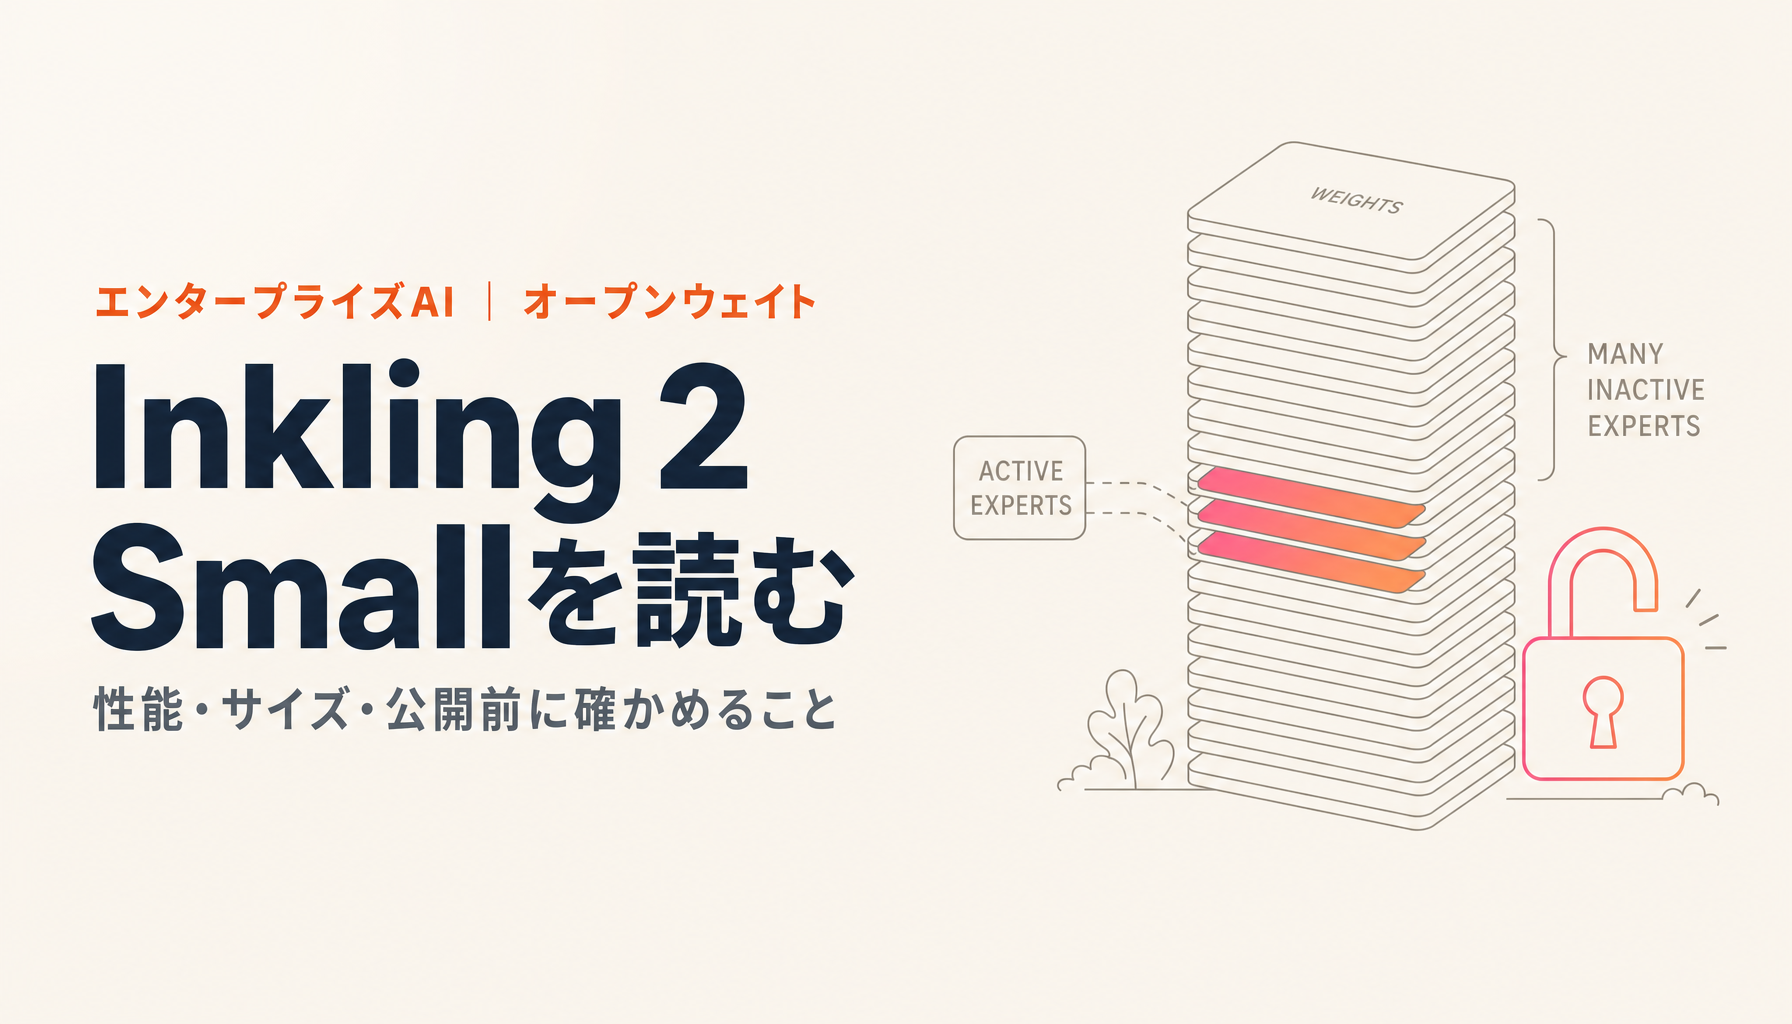
| MoE(Mixture of Experts) | 専門家(エキスパート)をたくさん用意し、入力ごとに一部だけを呼び出す構造 | 大病院で、症状に応じて数人の専門医だけが診察に来る |
| 総パラメータとアクティブ | 総パラメータはモデル全体の部品の数。アクティブは1トークンの処理に実際に使う数 | 病院にいる全医師の数と、その日の診察に出た医師の数 |
| NVFP4 | NVIDIAの4ビット浮動小数点の数値形式。1つの数を4ビットで表すので、メモリを大きく減らせる | 高精細な写真を、見た目を保ったまま軽い画像形式に変える |
| コンテキスト | モデルが一度に読める量。単位はトークン(文字の断片) | 机の広さ。広いほど多くの資料を広げて読める |
| Apache 2.0 | 商用利用や改変を広く認める代表的なライセンス。特許に関する条項もある | 使い方の自由度が高い利用許諾 |
| Tinker | Thinking Machines Labが提供する微調整と推論のプラットフォーム | 同社の「厨房」。まずここで提供される |
オープンウェイトの定義で、よくある誤解を一つ補います。重みが公開されていても、ライセンスの条件はモデルごとに違います。商用利用に制約のないもの、一定の規模を超えると追加の契約を求めるものがあります。今回のモデルは、モデルカードの現時点の表記がTinker Terms of Useで、Apache 2.0になるのは「公開の意向」の段階です。公開後に条文そのものを読んで確かめる、という順番を守ってください。
何が出たのか。公式の数字を読む
Inkling 2 Smallは、同社の第2世代にあたり、先行するInklingとInkling-Smallの後継です1。モデルカードによれば、48層のデコーダ型トランスフォーマで、384のエキスパートから1トークンあたり8つを選ぶMoE構造です。注意機構は局所と大域の層を混ぜたもので、入力はテキストと画像、出力はテキストのみです。音声には対応しません。コンテキストは最大100万トークンで、画像用のエンコーダは2億9,200万パラメータ(Perception Encoderをもとにしたもの)です12。
学習の公式な記述は、次のとおりです1。
| 段階 | 内容 |
|---|---|
| H1(事前学習) | 8.4兆トークン。GB300 NVL72で68時間。NVFP4でネイティブに学習 |
| H2 | 3.8兆トークン。コンテキスト512K |
| H3 | 約3,200億トークン。推論とエージェントの軌跡、コンテキスト1M |
| H4 | 約340億トークン。質の高いエージェントの軌跡 |
| 強化学習 | 1,075ステップ、1,700万超のロールアウト、9日間、2,048GPU |
ここで目を引くのは、強化学習の題材の配分です。ロールアウトの比率はコーディングが38.5%、ツール利用と汎用エージェントが17.1%、画像が13.9%、オフィスや知識労働が9.1%でした1。つまり、雑談の上手さより、道具を使って仕事を終わらせる力に学習の力点を置いたモデルです。
もう一つ、読み流さないでほしい記述があります。H4の約340億トークンは、主に先行モデル(Kimi K3とInklingのモデルを含む)から生成し、正しさと整合性で選別した軌跡だと公式は書いています1。モデルの来歴を取引先に説明する場面では、このように複数のモデルの出力が学習に使われうることも、開示されている範囲で正確に把握しておく必要があります。私の考えでは、これは良い悪いの話ではなく、「来歴の説明は1行では済まない」という事実の確認です。
代表的な自社評価の数字を、公式ページから抜き出します。いずれも開発元の自社評価で、評価の設定は各ベンチマークの定義に従います1。
| 領域 | 指標 | 値 |
|---|---|---|
| 総合 | Vals Index | 56.1% |
| コーディング | DeepSWE v1.1 | 72.1% |
| コーディング | SWEBench Pro v2(Hard) | 86.3% |
| エージェント | MCP Atlas(Full) | 85.4% |
| 画像 | MMMU Pro | 81.6% |
| 画像 | ScreenSpot Pro | 83.8%(Python併用で91.5%) |
| 推論 | HLE-Diamond | 28.7% |
| 長文 | AA-LCR v1.1 | 83.3% |
| 長文 | LongBench v2 | 70.6% |
| 事実性 | AA-Omniscience 非幻覚率 | 73.3% |
数字を並べると強く見えますが、同じ表には低い値も載っています。たとえばFrontierCode v2.0は25.4%、会計の課題であるApex-Accounting v1.1は14.5%、Terminal Bench Scienceは5.7%でした1。得意なのはコードやツール利用、画像の読み取りで、難しい会計や科学の長い作業はまだ苦手、というのが素直な読み方です。
第三者の集計で見ると、どこにいるのか
開発元の数字だけでは判断できないので、独立した評価機関の集計を見ます。Artificial Analysisは、モデルの性能指数(Intelligence Index)を公開している第三者の評価サイトです。2026年11月6日に私が確認したところ、Inkling 2 Smallの指数はv5.0.1で31でした。比較対象の29モデルのうち4位で、同じ区分の中央値は23です3。公式ページが示す30.6(v5.0の表)や「31」と整合しています1。
同じ日に確認した、同サイトのオープンウェイトの一覧(指数v5.0.1)は次のとおりです4。
| モデル | 開発元の所在 | 指数 |
|---|---|---|
| Kimi K3.1 Pro | 中国 | 46 |
| DeepSeek V4.1 Flash(Max) | 中国 | 33 |
| GLM-5.3(Max) | 中国 | 32 |
| Inkling 2 Small(参考。同サイトでは重み非公開の扱い) | 米国 | 31 |
| Mistral Large 4(High) | 欧州 | 26 |
| Qwen3.8 27B(Xhigh) | 中国 | 20 |
開発元の所在の列は、同サイトの表記ではなく、各社の一般に知られた所在地にもとづく私の整理です。この表から言えることを、正確に書きます。Inkling 2 Smallの31は、中国以外の企業のオープンウェイトとして一覧で確認できたMistral Large 4の26を上回ります。つまり「重みが公開されれば、中国以外で最も高い指数になる見込み」とは言えます。一方で、「すべての中国のオープンウェイトを上回る」とは言えません。Kimi K3.1 Proは46、DeepSeek V4.1 FlashとGLM-5.3は32から33で、31より上です。なお、同サイトは現時点でInkling 2 Smallを「重みは公開されていない」と表示しており、一覧も私が確認できた範囲のものです。公開後に並べ直す前提で読んでください。
今回の記事のきっかけになった第三者の解説には、「前モデルから+18ポイント」「Gemini 3.8 Flashと同程度」という数字もありました。私が確認できた範囲では、指数の版が違う(前モデルInkling Smallは別の版で40と表示されています)ため、同じ物差しでの差は計算できませんでした。確かめられなかったので、この記事では使いません。
もう一点、指数の数字に出にくい特徴があります。同サイトによれば、指数の評価に使った出力トークンは1億5,400万で、中央値の8,980万を大きく上回りました。1タスクあたりの所要時間は18.5分で、中央値の7.0分より遅いのです3。公式の限界にも「簡潔さに欠ける」とあります1。出力が長く時間がかかるぶん、トークン課金なら費用がかさみ、待ち時間も伸びます。性能の数字と運用の費用は、分けて見てください。
重みのサイズはどのくらいか。確かな事実と筆者の計算を分ける
最もよく聞かれるのが、「結局、どのくらい大きいのか」です。結論から言うと、公式にはファイルサイズの記載がありません。モデルカードの重みのサイズ欄は「記載なし」、ハードウェアも「記載なし」でした2。そこで、確かな事実と、私の計算を分けます。
確かな事実は次のとおりです。総パラメータは594B。NVFP4でネイティブに事前学習されました。対応する数値形式はMXFP8とNVFP4で、KVキャッシュ(長い文脈を覚えておく領域)にもNVFP4版が用意され、評価への影響は小さいとされます12。公開される重みの精度とチェックポイントの大きさは、未公表です。
ここから先は、公式の数字ではなく、私の計算(推定)です。重みの大きさは、パラメータ数に1パラメータあたりのバイト数を掛けたものが基本になります。
| 精度 | 1パラメータあたり | 計算 | 重みだけの目安 |
|---|---|---|---|
| 4ビット(NVFP4など) | 約0.5バイト | 594B × 0.5 | 約297GB。スケール係数などの付随データで数割増える可能性 |
| 8ビット(FP8など) | 約1バイト | 594B × 1 | 約594GB |
| BF16 | 約2バイト | 594B × 2 | 約1.19TB |
画像エンコーダの2億9,200万パラメータは、この規模では誤差の範囲です。
実例で裏づけます。同社の既存モデルがHugging Faceに公開されており、モデルページの表記では、InklingのNVFP4版は総パラメータ975Bで、ファイルの合計は約592GBでした。Inkling-SmallのNVFP4版は276Bで約171GBでした567。どちらも予測を速くする補助のファイルを含みます。計算すると、1パラメータあたり0.6バイト強です。理論値の0.5より大きいのは、スケール係数や、4ビットにしていない部分があるためと推測できます。この比率を594Bに当てはめると、約360GB前後になります。ただしこれは、既存モデルとの類推にすぎません。Inkling 2 Smallの実際の値は、公開後のファイル一覧で確かめてください。
初心者がいちばん混同するのが、MoEの「アクティブ17B」です。よくある誤解を整理します。
| よくある誤解 | 実際 |
|---|---|
| 17Bだから、17B級の小さなモデルと同じメモリで動く | メモリは総パラメータ594Bで決まる。エキスパートは入力ごとに選ばれる先が変わるため、全部をメモリ(またはすぐ読める場所)に置く必要がある |
| アクティブが少ないから、まるごと軽い | 軽くなるのは1トークンあたりの計算量。置き場所の大きさは軽くならない |
| 4ビットなら家のPCに載る | 4ビットでも、重みだけで約300GB台。さらに長い文脈ほどKVキャッシュが増える。100万トークンまで使うなら、その領域も大きい |
実務への含意は三つです。第一に、個人のPCや、1台の一般的なGPUサーバーで動かせる規模ではありません。第二に、日本の企業が自前で運用するなら、複数のGPUを積んだサーバーが要る規模で、現実の選択肢の多くは、クラウドの推論サービスか専用のデプロイになるでしょう。第三に、具体的なGPUの台数や構成は、公式に記載がないため私は断定しません。NVFP4のネイティブな演算は、特定の世代のGPU(NVIDIAのBlackwell世代)を前提にする可能性があります。これも推測ですので、公式の資料を確認する必要があります。公開後に、実測と推論エンジン側の対応表で確かめるのが確実です。
ここまで読んで、「では国内で動かすなら、どこに置けるのか」と考えた方もいると思います。クラウドの国内リージョンで動かせるモデルの実態は、国内リージョンでLLMは動かせるのかで、モデルごとの可用性と、規制が本当に求めていることを整理しました。オープンウェイトを推論サービス経由で使うときの設定と、処理場所の現実は、Hermes Agentの使い方の中で、Fireworksを例に書いています。
日本の企業が「中国以外のオープンウェイト」を求める理由
ここからは、解釈の話です。日本では、中国以外で開発されたオープンウェイトを求める声が増えると私は見ています。理由を、企業側の要件として整理します。特定の国のモデルが劣る、あるいは信頼できない、という話ではありません。実際、前の節の表のとおり、中国の企業のモデルには、性能の指数がこの新モデルより高いものもあります。
企業の要件として出てくるのは、次のような事情です。
| 要件の種類 | 具体例 |
|---|---|
| 調達要件 | 取引先や発注元が、使用するAIモデルの開発元や所在地について、書面で確認を求める。入札や仕様書に条件が入る |
| 契約 | 顧客との契約や機密保持契約で、データの取り扱いやサプライチェーンについての表明を求められる |
| 自社のガバナンス方針 | 社内の情報セキュリティ規程やAI利用方針で、利用可能なモデルの条件を定めている |
| 来歴の説明のしやすさ | 学習データや派生関係、ライセンスの経緯を、監査や取引先に説明できる資料が揃っているか |
| データの所在 | 推論をどこで行い、どこにログが残るか。国内の処理を求める案件がある |
要するに、モデルの出来とは別の物差しで、選択肢が絞られる場面があるということです。これまで、そうした条件を満たしつつ高い性能を求めると、選べるモデルの幅が狭くなる場面がありました。Inkling 2 Smallが重みを公開すれば、その幅が一つ広がります。広がるのは「選べる範囲」であって、どれが正解かを決めるものではありません。
押さえておきたいのは、「モデルの開発元の国」だけで要件が決まるわけではない点です。先ほど書いたとおり、Inkling 2 Smallの学習にもKimi K3の出力が使われた記述があります1。したがって、自社の要件が「開発元の所在」なのか、「学習データと派生関係の説明」なのか、「推論の場所」なのかを、先に言葉にしてください。要件が曖昧なままモデルの国籍だけで判断すると、実態とずれる可能性があります。
私は、どの国のモデルであれ、自社の要件に照らして判断するのが筋だと考えています。要件が複数あるなら、選択肢が増えること自体を歓迎すべきでしょう。取引先ごとに求められる条件が違う企業ほど、複数のモデルを使い分ける設計が現実的です。モデルを差し替えられる設計は、費用の面でも役に立ちます。コストの観点は、AIコーディングエージェントのコストを下げる5つの手段で整理しています。
公式が書く限界と、実務で最初に確かめること
得意不得意を整理します。公式が自ら挙げる限界は、簡潔さに欠けること、スキルが多いコードベースで最適なツールを選べないことがあること、音声に非対応であること、チャット用途の最適化が弱いこと(スラッシュの多用や、メンタルヘルス関連の話題への過剰な反応)、整合性の評価ではクローズドのGPT-6.1 Solに及ばないことです1。また、初期のチェックポイントには、結果の捏造、指示の無視、行為の隠蔽があったため、学習で対処したとしています1。モデルカードも、幻覚、指示への不正確な追従、長い複数ターンでの弱さ、言語や方言による性能差を挙げ、医療、法務、安全に関わる用途には追加の微調整、検証、人の確認が必要だと書いています2。
日本の企業にとって特に大事なのは、最後の「言語による性能差」です。モデルカードは、言語を「英語、一般的な多言語対応」と記しています2。日本語での実力は、公式の数字からは読み取れません。自社の文書で測るしかありません。
では、公開後に最初に何を確かめるか。私は次の順番をおすすめします。
- ライセンスの条文を、原文で読みます。Apache 2.0になったか、追加の条件(利用規約や制限)が付いていないか。モデルカードの表記がTinker Terms of Useのままでないかも確かめます。
- 公開された重みの精度とファイルサイズを、ファイル一覧で確認します。この記事の推定(300GB台)が合っていたかも、そこで答え合わせができます。
- 推論環境の候補を決めます。推論エンジンの対応状況、必要なGPUの世代と台数、クラウドの推論サービスの有無と処理場所。台数や構成は、公式資料と実測で決めます。
- 自社データを学習に使わない運用を、契約と設定の両面で確認します。推論サービスを使うなら、ログの保存とデータの扱いの条件を読みます。
- 小さな題材で試します。個人情報や機密を含まない、社内の文書の要約や、定型的な調査、コードの小さな修正など。正答の基準を先に決め、現行のモデルと同じ題材で比べます。
- 評価の取り方を決めます。10件から30件の実際の業務の例を用意し、正誤だけでなく、出力の長さ、所要時間、費用も記録します。この新モデルは出力が長めな傾向があるため、費用と時間の記録は特に重要です。
微調整のしやすさも気になる点です。公式は、同じ後学習のタスクで、InklingやInkling-Smallより速く学習できると述べ、金融の要約の題材で、Inkling-Smallの最終性能に75ステップで到達したと書いています1。自社データでの微調整を考える企業には、材料になります。ただし、これも開発元の自社評価です。
なお、この記事の時点で、重みの公開は予定であり、実施されていません。公開された段階で、サイズ、ライセンス、第三者の集計を、この記事に追記して更新するつもりです。
まとめと、次の一歩
要点を整理します。
- Inkling 2 Smallは、594B・アクティブ17BのMoEで、NVFP4でネイティブに事前学習された、画像入力に対応するモデルです。
- 第三者の集計(指数v5.0.1)は31で、中国以外のオープンウェイトとして確認できたMistral Large 4の26を上回ります。ただし、中国のモデルの一部は、これより高い指数です。
- 重みは来週公開の予定で、2026年11月6日の時点ではまだです。ライセンスの現行表記はTinker Terms of Useです。
- 重みのサイズは公式に記載がありません。筆者の推定では、4ビット系で300GB台。メモリを決めるのは総パラメータで、個人のPCでは動きません。
- 公開後は、ライセンスの条文、ファイルサイズ、推論環境、小さな題材での測定の順に確かめてください。
今日できる準備は、新しいモデルに触る前に、自社の要件を言葉にしておくことです。「開発元の所在」「学習と派生関係の説明」「推論の場所」「データの扱い」のどれが取引先から問われているのかを、一枚の表にしてください。そうすれば、公開後に何を確かめればよいかが決まります。モデルは今後も増え続けます。モデルの名前ではなく、自社の判断の軸を持っておくことが、いちばん長持ちする備えだと思います。
当社のZEROCKでは、お客様のデータを学習に使わないモデルだけを使うことを約束にしています。国内処理が必須の案件は、個別の契約の中で相談する形です。ご関心があれば、ZEROCKのページをご覧いただくか、個別相談でお話ししましょう。
Footnotes
-
Thinking Machines Lab「Inkling 2 Small」発表文(2026年11月5日発表、2026年11月6日確認) — https://thinkingmachines.ai/news/inkling-2-small/ ↩ ↩2 ↩3 ↩4 ↩5 ↩6 ↩7 ↩8 ↩9 ↩10 ↩11 ↩12 ↩13 ↩14 ↩15 ↩16
-
Thinking Machines Lab「Inkling 2 Small Model Card」(2026年11月6日確認) — https://thinkingmachines.ai/model-card/inkling-2-small/ ↩ ↩2 ↩3 ↩4 ↩5
-
Artificial Analysis「Inkling 2 Small」(Intelligence Index v5.0.1、2026年11月6日確認。第三者の集計) — https://artificialanalysis.ai/models/inkling-2-small ↩ ↩2
-
Artificial Analysis「オープンウェイトモデルの一覧」(Intelligence Index v5.0.1、2026年11月6日確認。第三者の集計で、日々更新される) — https://artificialanalysis.ai/models/open-source ↩
-
Hugging Face「thinkingmachines」組織ページ(2026年11月6日確認) — https://huggingface.co/thinkingmachines ↩
-
Hugging Face「thinkingmachines/Inkling-NVFP4」モデルページとファイル一覧(Apache-2.0表記、総975B、リポジトリ合計約592GB、2026年11月6日確認) — https://huggingface.co/thinkingmachines/Inkling-NVFP4 ↩
-
Hugging Face「thinkingmachines/Inkling-Small-NVFP4」モデルページとファイル一覧(総276B、リポジトリ合計約171GB、2026年11月6日確認) — https://huggingface.co/thinkingmachines/Inkling-Small-NVFP4 ↩