こんにちは、株式会社TIMEWELLの濱本です。
FDE実践シリーズの6本目です。ここまでの5本で、現場から集める技術を書いてきました。インタビューで名詞と動詞を書き留め、観察で確かめ、エスノグラフィーで意味を厚くし、KJ法で構造にし、ビデオで数字を足す。5本のどこにも「名詞と動詞の辞書」が出てきます。今回は、その辞書をどうやってAIが辿れる形にするかを書きます。
以前、FDEとAI伴走支援の違いの記事で、名詞と動詞を教えずにエージェントは走れない、と書きました。エージェントが「注文を引き当てる」という行為をするには、その会社で注文とは何で、引き当てるとは何をすることで、引き当ての前後に何があるかを、機械が読める形で持っている必要があります。この形が、オントロジーです。難しい言葉ですが、やっていることは、その会社の言葉で世界を切り分けて、機械に渡すことです。自社の業務用語がどこまでAIに渡せる形になっているかを先に確かめたい方は、AIリテラシー診断を使ってください。
オントロジーとは何か。その会社の言葉で世界を切る
オントロジーという言葉は哲学から来ていますが、情報科学では1993年にトム・グルーバーが「概念化の明示的な仕様」と定義しました。ある領域に何があり、それらがどう関係しているかを、共有できる形で明示的に書き表したものです1。要するに、その領域の名詞と動詞と関係を、曖昧さなく書いた辞書です。
この考えを企業向けの製品の中心に置いたのがPalantirです。同社の文書では、オントロジーは統合されたデータの上に置かれる層で、データを現実世界の対応物に結びつけるものとされ、構成要素としてオブジェクトの型、プロパティ、リンク、アクションの型、関数が挙げられています2。オブジェクトが名詞、リンクが関係、アクションが動詞にあたります。Palantirで8年間FDEを務めた人物は、この「オントロジー」を同社の古い社内用語の一つとして挙げていますが3、FDEが現場で学んだ業務の意味を製品に返すとき、その受け皿がオントロジーだった、という構造が見えます。
なぜ、AIエージェントの時代にこれが要るのか。理由は、エージェントが行動するからです。文章を要約するだけのAIなら、その会社の言葉の定義が曖昧でも動きます。しかし「承認待ちの注文を引き当てて、出荷指示を出す」というエージェントは、承認待ちとは何か、引き当てとは何か、出荷指示は誰の権限か、を知らなければ動けません。動いたとしても、間違った引き当てをします。名詞と動詞の定義が、エージェントの行動の根拠です。
発話録から辞書へ。名詞、動詞、関係、状態、例外の五つを抜く
ここからが手順です。材料は、シリーズの1本目から5本目で集めたものです。インタビューの逐語録、観察の五列の記録、エスノグラフィーの三層のノート、KJ法の束の名前、ビデオの計数。ここから五つを抜き出します。
| 抜くもの | 何か | 発話録の例 | 辞書での書き方 |
|---|---|---|---|
| 名詞 | その会社で使われるものの名前 | 「注文が来たら、まず在庫を見ます」 | 注文、在庫 |
| 動詞 | 名詞に対して人がする行為 | 「在庫を引き当てて、確保にします」 | 引き当てる(在庫を注文に)、確保する(営業が口頭で) |
| 関係 | 名詞と名詞のつながり | 「注文には必ず出荷が紐づきます」 | 注文は出荷を持つ(1対1以上) |
| 状態 | 名詞が取りうる段階 | 「承認待ちのものは触りません」 | 注文の状態は、受付、承認待ち、承認済、出荷済 |
| 例外 | 普段と違う経路と条件 | 「急ぎのときは係長が押します」 | 承認の判断者は課長、ただし急ぎ区分のときは係長 |
名詞は、システム用語に翻訳せずに、その会社の語のまま書きます。「引き当て」と「確保」が別の意味なら、別の動詞として書きます。ここで、KJ法の記事で書いた束の名前が効きます。「承認の実態は、係長の判断と課長の押印の二段になっている」という束の名前は、そのまま「承認する」という動詞の定義になります。辞書には「承認するとは、係長が判断し、課長が押印することである」と書きます。二段であることを辞書に書いておけば、エージェントは一段目で止まりません。
関係と状態は、観察とビデオから確かめます。発話録には「注文には必ず出荷が紐づく」とありますが、画面録画を見ると、出荷なしで完了になっている注文があるかもしれません。その場合、関係は「注文は出荷を持つ、ただしサンプル出荷は除く」と直します。発話と観察のずれが、辞書の精度を上げます。
例外は、いちばん大事で、いちばん抜け落ちるものです。「急ぎのときは係長が押す」は、機能一覧には載りませんが、辞書には載ります。エージェントが急ぎ区分の注文を課長の承認待ちにして止めるか、係長に回すかは、この一行で決まります。
抽出には、AIを使います。逐語録と観察記録を読ませ、五つの候補を一覧にさせます。候補を出す速さは機械が上で、数百の断片から数十の名詞と動詞が数分で出ます。ただし、確定は人がします。理由は、同じ語が部署によって別の意味を持つからです。営業の「確保」と倉庫の「確保」は別の行為で、機械の抽出では一つにまとまります。辞書には「確保する(営業)」「確保する(倉庫)」と分けて書き、どちらの意味かを文脈で決める規則を添えます。この分割は、エスノグラフィーで意味を厚くした人にしかできません。
辞書を機械が辿れる形にする。グラフとエージェント
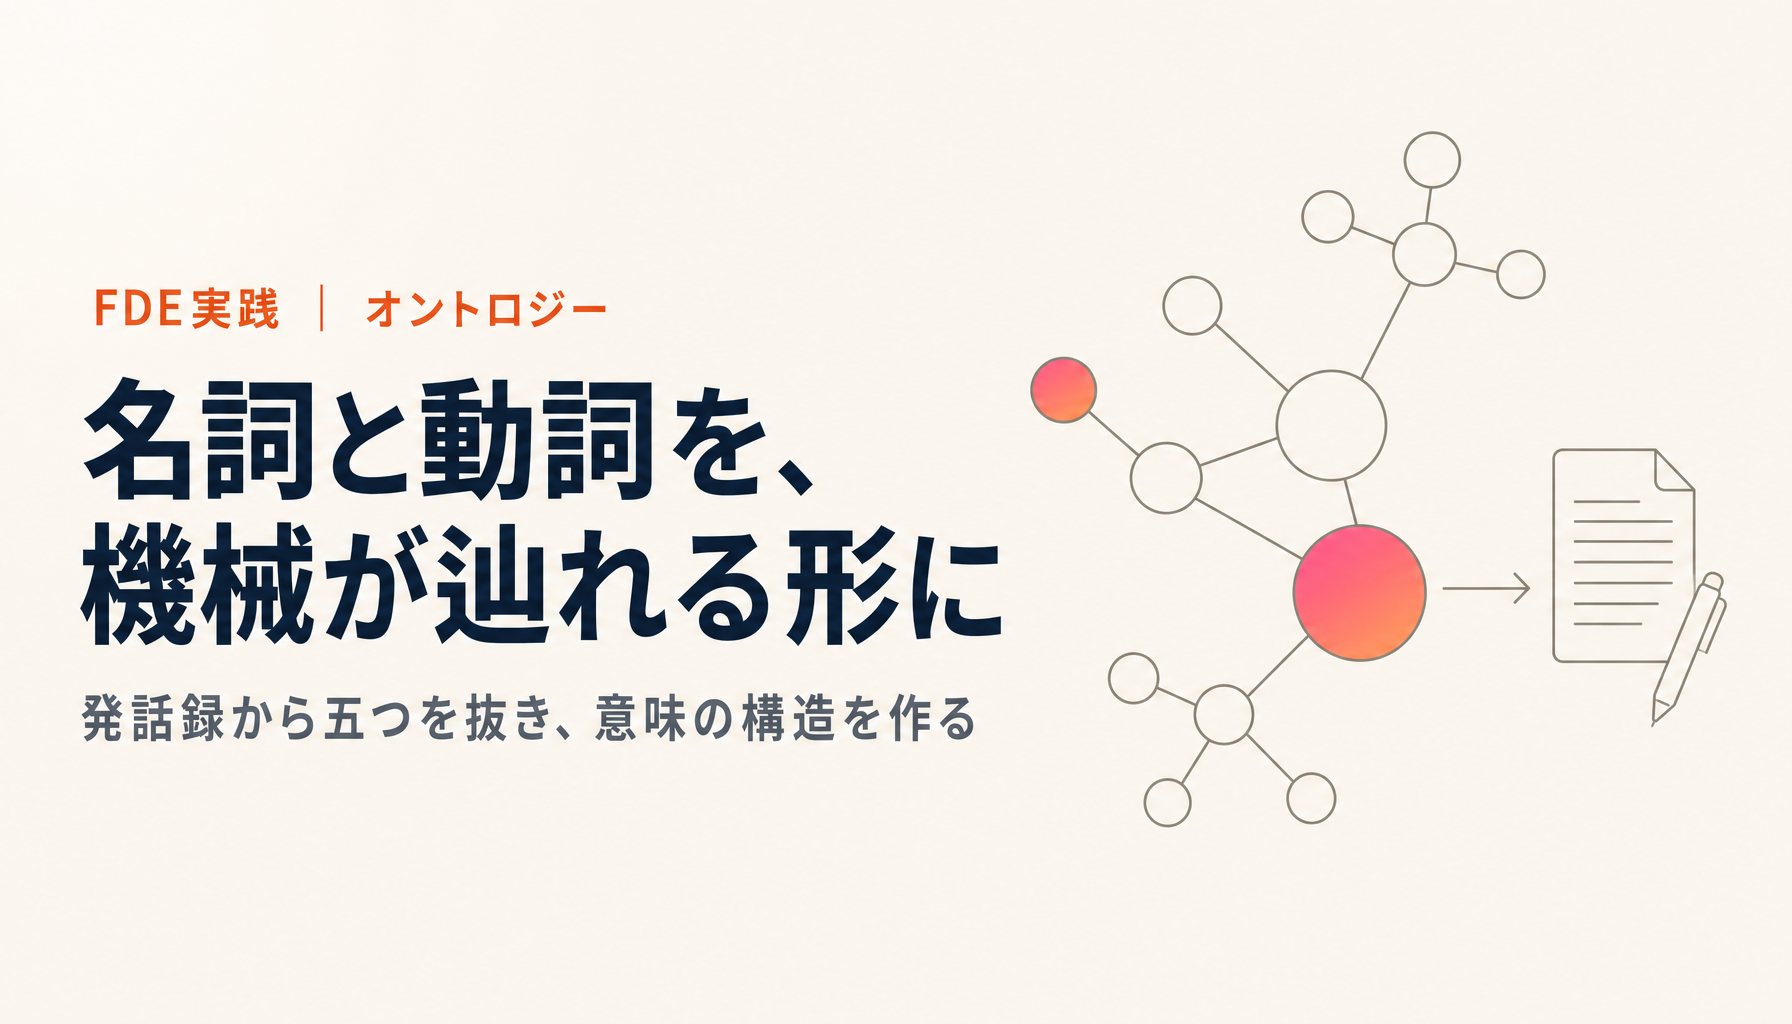
辞書ができたら、機械が辿れる形にします。名詞をノード、関係をエッジにした、グラフの形です。状態はノードの属性、動詞はノードに対して許される操作、例外は操作の条件として持ちます。
この形にする理由は、エージェントが質問に答えるだけでなく、辿って行動するからです。「この注文は出荷できるか」という問いに答えるには、注文のノードから、状態(承認済か)、関係(在庫が引き当てられているか)、例外(急ぎ区分なら係長承認で足りるか)を順に辿る必要があります。文書の束を検索するだけでは、この辿りができません。大規模言語モデルと知識グラフを組み合わせて、文書全体にまたがる問いに答える方法は、GraphRAGとして2024年に体系化されました4。当社のZEROCKは、社内の知識をこの形で持ち、エージェントが辿れるようにする製品で、現場で作った辞書がそのまま製品の構造に入ります。
ここで、a16zが2026年1月の論考で書いた「再利用可能なプリミティブ」の話につながります。同稿は、本物のFDEの型を、顧客ごとに新しい機能を作るのではなく、データモデルやワークフローの部品といった再利用可能なプリミティブの上に築くものだと整理しています5。オントロジーは、その最も基本的なプリミティブです。「注文は状態を持つ」「承認は複数段になりうる」「例外は区分で分岐する」という構造は、会社が変わっても変わりません。変わるのは、状態の名前と段数と区分です。だから、構造を製品の標準スキーマに持ち、名前と段数と区分を顧客ごとの設定にします。3社で見た「承認は二段」が製品のスキーマになり、「この会社では急ぎ区分は係長」が設定になる。KJ法の記事で書いた型と枝の分け方は、ここで製品の構造に着地します。
エージェントの動かし方の詳細は、コンテキストエンジニアリングの記事で書きました。辞書は、エージェントに渡すコンテキストの中で、いちばん変わりにくく、いちばん間違えると痛い部分です。
受託のデータモデリングとの違い
受託開発にも、データモデリングの工程があります。エンティティを洗い出し、関係を定義し、データベースの設計に落とします。名詞と関係を書き出す点は同じに見えます。違いを表にします。
| 観点 | 受託のデータモデリング | FDEのオントロジー |
|---|---|---|
| 目的 | システムのデータベースを設計する | AIエージェントが行動する根拠を作る |
| 出典 | 要件定義書 | 現場の発話、観察、ビデオ |
| 動詞と例外 | 機能仕様として別に書く | 名詞と一緒に、条件つきで書く |
| 更新 | 設計フェーズで凍結 | 毎週、動くものへの反応で更新 |
| 帰属 | 顧客のデータベース | 型は製品の標準スキーマ、枝は顧客の拡張 |
| オーナー | 開発側 | 現場側に置き、FDEが去った後も更新できるようにする |
いちばん大きな違いは、動詞と例外の扱いです。データモデリングは名詞と関係を扱い、動詞は機能仕様として別の文書に、例外は「その他」として備考に書かれます。オントロジーは、動詞と例外を名詞と同じ場所に、条件つきで書きます。エージェントにとって、「承認する」という動詞と「急ぎは係長」という例外は、「注文」という名詞と同じくらい重要だからです。
もう一つの違いは、オーナーです。受託のデータモデルのオーナーは開発側で、変更は改修の契約になります。FDEのオントロジーは、現場側にオーナーを置きます。現場の担当者が「急ぎ区分の判断者が変わった」と辞書を直せば、エージェントの行動が変わる。この状態を作って、FDEは現場を出ます。AWSが2026年6月に立ち上げたFDE組織は、終了時に顧客が自走できる状態を残すことを設計の中心に置いていますが6、当社にとっての自走の条件は、辞書のオーナーが現場にいることです。
現場での手順。週次で辞書を更新し、動くものに反映する
手順は、週次で回ります。月曜から木曜に現場で集め、金曜にKJ法で束を作り、束の名前から五つを抜いて辞書を更新し、翌週の月曜に更新した辞書をエージェントに読ませて動くものを置き、担当者の「何が違いますか」を聞いて、辞書を直す。この一周が一週間です。
辞書には版を振ります。「承認する」の定義が、第1週は「課長が押印する」、第2週は「係長が判断し課長が押印する」、第3週は「急ぎ区分は係長のみ」と変わっていくのが普通です。版を残しておくと、エージェントの行動が変わった理由を後から辿れます。担当者に「先週と挙動が違う」と言われたとき、辞書の差分を見せれば説明が終わります。
そして、辞書のオーナーを決めます。当社のエンジニアが現場にいる間は当社が更新しますが、終了までに現場の担当者に引き継ぎます。引き継ぐのは、五つを抜く手順と、部署ごとの意味の分け方と、版の残し方です。担当者が自分で「急ぎ区分の判断者は係長から主任に変わった」と直せるようになれば、FDEは要らなくなります。要らなくなることが、この工程の完了条件です。
当社の実践と限界
正直に書きます。辞書は生き物で、完成しません。現場の言葉は変わり、組織は変わり、例外は増えます。当社が持ち帰った辞書が半年後に古くなっていた、ということは、オーナーを現場に置き損ねたときに起きます。だから、オーナーの引き継ぎを完了条件にしています。
限界も書きます。AIの抽出は、候補を出すところまでです。「同じ語で別の意味」「別の語で同じ意味」は、機械には分かりません。発話録に「確保」が40回出てきて、そのうち何回が営業の確保で何回が倉庫の確保かは、そこにいた人が振り分けます。それから、辞書は集めた断片の質を超えません。インタビューが会議室だけなら、辞書は「あるべき業務」の辞書になり、エージェントは実際の業務で止まります。1本目から5本目の技術が先にある理由は、ここにもあります。
最後に、製品との関係を正直に書きます。当社のZEROCKは、この辞書を構造として持つ製品です。だから当社のFDEは、辞書を作りながら製品を育てています。これは利益相反ではなく、FDEの型そのものです。学びが製品に返らないなら、それは受託です。ただし、辞書のオーナーは顧客にあり、辞書の内容は顧客のものです。製品に返るのは構造であって、その会社の名詞と動詞そのものではありません。
まとめ
現場で集めた名詞と動詞の辞書は、辞書のままではエージェントが使えません。発話録と観察記録から、名詞、動詞、関係、状態、例外の五つを抜き出し、グラフの形にして、エージェントが辿れるようにします。これがオントロジーで、その会社の言葉で世界を切り分けて機械に渡す作業です。
受託のデータモデリングとの違いは、動詞と例外を名詞と同じ場所に条件つきで書くこと、毎週更新すること、型は製品の標準スキーマに返し枝は顧客の拡張として持つこと、そしてオーナーを現場側に置くことです。FDEが要らなくなることが、この工程の完了条件です。
自社の業務用語をエージェントが辿れる形にしたい方、あるいは現場の辞書を製品の構造に変える相手を探している方は、WARPのプログラムをご覧いただくか、個別相談でお話ししましょう。次の記事では、ここまでの技術を一週間の中でどう回すか、FDEの1週間を初日から金曜まで書きます。
Footnotes
-
Gruber, T. R. (1993). A translation approach to portable ontology specifications. Knowledge Acquisition, 5(2), 199–220. DOI: 10.1006/knac.1993.1008。「概念化の明示的な仕様(an explicit specification of a conceptualization)」は同論文による ↩
-
Ontology overview(Palantir Foundry ドキュメント)。構成要素の説明は同文書による(筆者の要約) ↩
-
Edge, D., et al. (2024). From Local to Global: A Graph RAG Approach to Query-Focused Summarization. arXiv:2404.16130 ↩
-
The Palantirization of everything(Marc Andrusko、a16z、2026年1月16日)。再利用可能なプリミティブ(データモデル、ワークフローエンジン、UI部品)の指摘は同稿による ↩
-
AWS invests $1 billion to embed AI forward deployed engineers with customers(Amazon、2026年6月30日) ↩